Google 让 AI 不再“写作文”:Gemini Decision 1 只做AI进化调研员一件事——做选择
不生成一个字,只给出概率。Google 新模型 Gemini Decision 1,可能是 AI Agent 时代最被低估的基础设施。
目录
不生成一个字,只给出概率。Google 新发布的 Gemini Decision 1,可能是 AI Agent 时代最被低估的一块基础设施。
11 月 11 日,Google 在 AI Studio 上线了一个看起来"不太 AI"的新东西:Gemini Decisions API,背后是一个新模型 Gemini Decision 1(模型代码 gemini-decision-1)。
它不聊天,不写代码,不生成任何一句话。你给它一段材料和一组问题,它只返回一件事:每个选项的概率,以及它有多大把握。
听起来很朴素,但如果你做过 AI Agent,大概会立刻意识到:这恰恰是 Agent 里调用次数最多、却最不该用大模型"写作文"去完成的那部分工作。
一、Agent 里最多的调用,其实都是"选择题"
拆开一个典型的 AI Agent,你会发现真正让它"写长文"的调用并不多,大量调用都是这样的:
- 这个请求该交给哪个模型?要不要开深度思考?
- 这一步该调用哪个工具?
- 这段输出有没有违反某条安全策略?
- 上下文太长了,该压缩、升级给人工,还是直接停止?
- 这十个检索结果,哪几个真的相关?
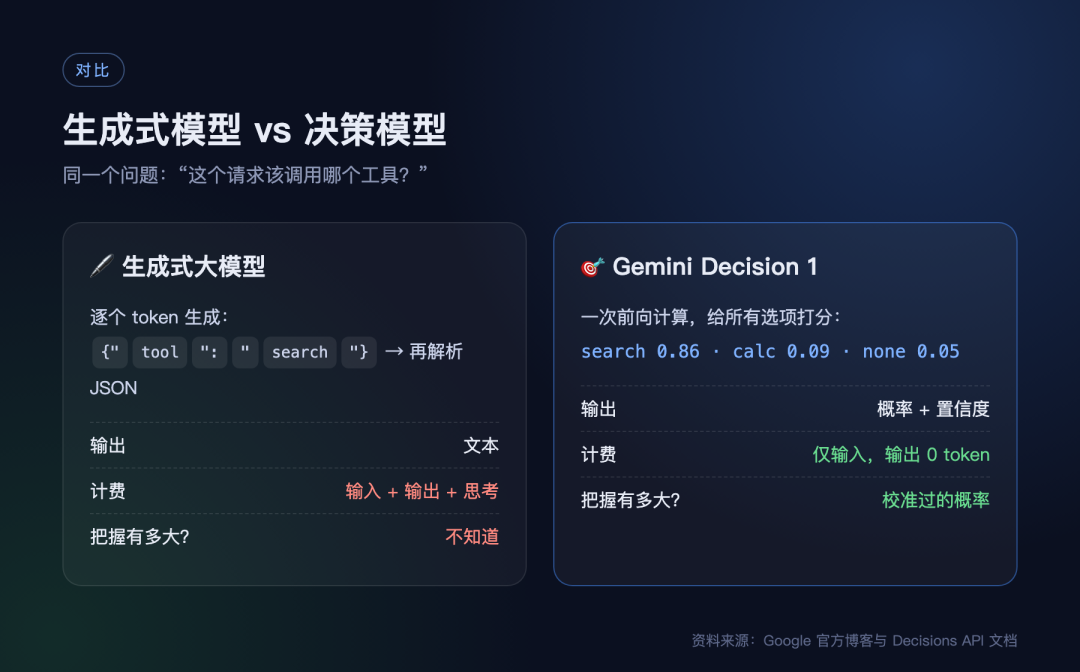
这些问题本质上都是封闭选项:答案就在一个有限的集合里。但过去我们只能用生成式大模型来回答——让它"输出一个 JSON",再去解析文本。
这带来三个老问题:
- 慢 :模型要一个 token 一个 token 地生成,还可能先"想"一大段;
- 贵 :输出 token、思考 token 都要付钱;
- 不可信的"自信" :模型说"是",但你不知道它是 51% 的"是"还是 99% 的"是"。
Gemini Decision 1 就是冲着这三个问题来的。
二、它是怎么工作的:一次前向计算,直接打分
Google 官方博客的描述是:Gemini Decision 1 不再逐 token 生成答案,而是在一次前向计算中给所有候选选项打分。
官方文档开篇就把定位说得很清楚:生成式模型产出的是"给人读的文字",而 Decisions API 产出的是经过校准的概率。一个直接的结果是——输出 token 永远是 0。
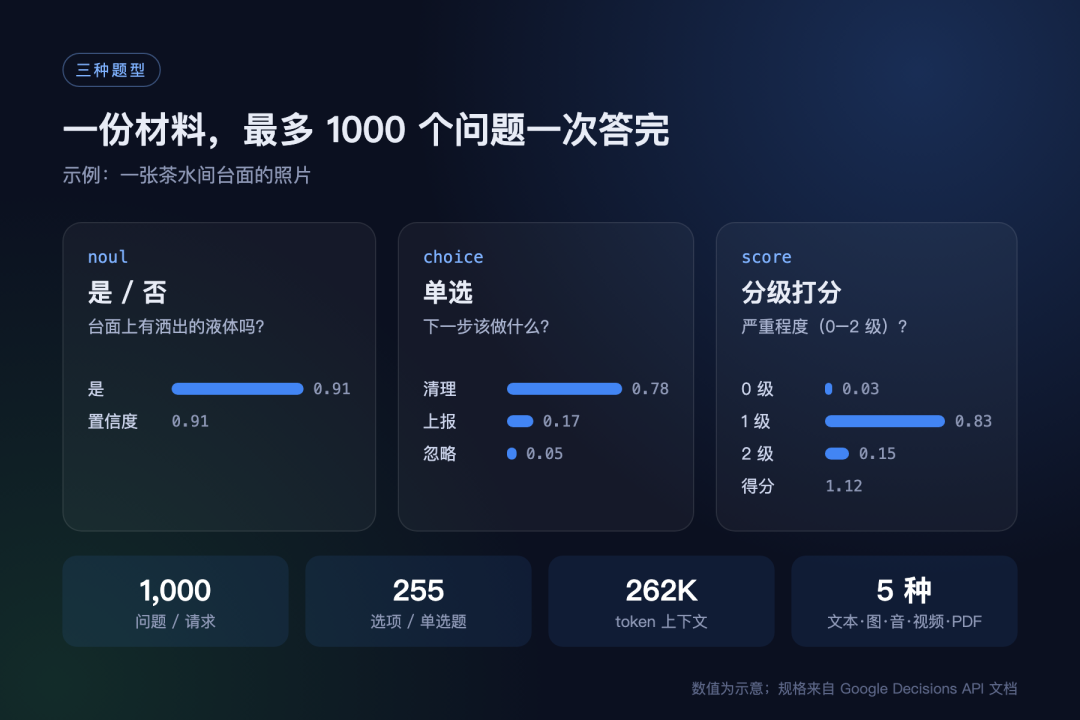
它支持三种题型:
| 题型 | 用途 | 返回 |
|---|---|---|
noul (是/否) | 有没有违规?需不需要工具? | “是"的概率 + 置信度 |
choice (单选) | 路由到哪个模型?选哪个工具? | 每个选项的概率(合计为 1) |
score (分级打分) | 严重程度、相关度、质量等级 | 加权分数 + 各级概率 |
几个关键规格(来自官方文档):
- 一次请求最多 1000 个问题 ,共享同一份输入材料——材料只计费一次;
- 单选题最多 255 个选项,分级题最多 255 个等级(建议 2–10 级);
- 上下文窗口 262,144 tokens(输入与所有问题共享);
- 输入支持文本、图片、音频、视频、PDF,但问题本身只能是文本;
- 是/否题的概率被限制在 0.01–0.99 之间。
举个官方博客里的例子:给它一张茶水间台面的照片,同时问三个问题——“有没有洒出来的液体?"(是/否)、“下一步该做什么?"(单选)、“严重程度几级?"(打分)。一次调用,三个带概率的答案一起返回。
一个返回结果长这样:
{ "type": "noul", "noul": 0.03, "confidence": 0.97 }没有一句废话,只有数字。
三、真正的卖点:概率是"校准过的”
很多人会觉得:让大模型输出 JSON,不也能做选择题吗?
区别在于校准(calibration)。所谓校准良好,是指模型说"80% 把握"的那些判断,实际上大约有 80% 是对的。只有这样,你才能放心地在代码里写:
置信度 > 0.9,自动执行;0.6–0.9,交给更强的模型复核;< 0.6,转人工。
Google 称 Gemini Decision 1 在其覆盖 Agent 路由、推理、排序与多模态理解的基准测试中整体领先,并且校准误差最低。
根据第三方 CellCog 对 Google 官方图表的读数,Gemini Decision 1 的校准误差约 0.025,而 Gemini 3.5 Flash-Lite 约 0.21——相差近一个数量级。
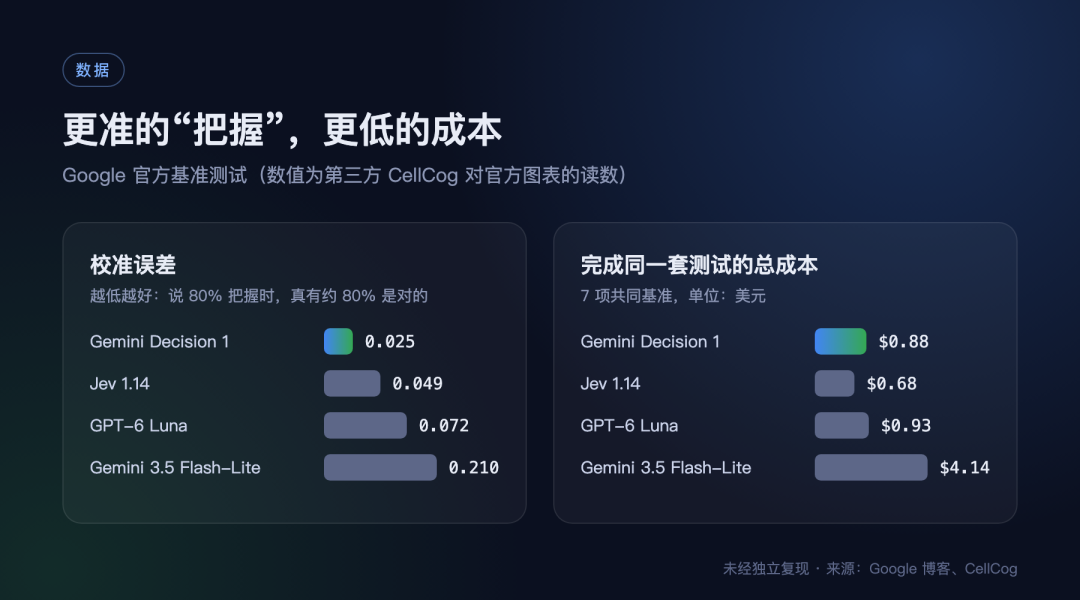
需要客观地说:这些数据都来自 Google 自己的测试(以及第三方对官方图表的"目测"转录),目前还没有独立复现。按 CellCog 的读数,在 7 个共同测试中它拿下了 5 个第一,但在 Mind2Web 多模态和 When2Call 两项上并非最佳——这和"全面领先"的说法略有出入。
官方文档也很务实地提醒:阈值要用你自己业务里的标注数据来定,别直接照搬。
四、算一笔账:快,而且便宜得离谱
价格:输入每百万 token 0.10 美元,输出 0 美元(因为根本没有输出)。没有思考 token 费用,也没有额外的音频转写、OCR 费用。免费层同样可用。
成本对比:Google 称在同一套基准测试上,它比用 Gemini 3.5 Flash-Lite(通过 Interactions API)做同样的事便宜近 5 倍。按 CellCog 的计算,大约是 0.88 美元 vs 4.14 美元。
延迟:官方给出的数字是端到端 150–250 毫秒,模型计算中位数 50–100 毫秒;在 16K token 以内的上下文中,从 1 个问题到 100 个问题,延迟几乎不变。
这意味着它可以被放进实时链路里——每一次用户请求、每一帧画面、每一步 Agent 动作之前,都可以先"问一下"它。
五、Google 自己已经在用了
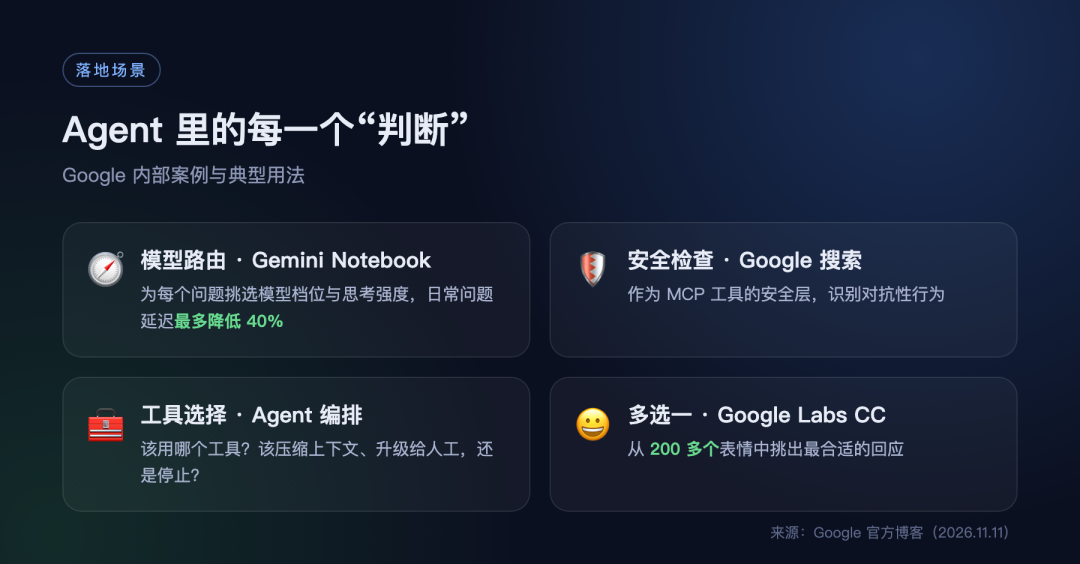
博客里披露了几个内部落地案例:
- Gemini Notebook :用它做实时路由,把每个问题分配给合适的模型档位和思考强度,日常问题的延迟最多降低 40%;
- Google 搜索 :作为 MCP 工具的安全层,识别对抗性行为;
- Stitch :在"快速画布"中用于生成线框图、应用编辑;
- Google Labs 的 CC :从 200 多个表情里挑一个最合适的来回应。
生态方面,OpenRouter、LangChain、Vercel、LiteLLM、Pydantic AI、Pipecat、LiveKit 等都已宣布接入。官方还提供了 Doorstep Parcels、Find the Zookeeper 等 Demo 和一个可以导出代码的 Decisions Playground。
六、它不适合做什么
这一点同样重要,官方文档写得很坦诚:
- 要生成文字、摘要、带参数的工具调用 ——请回去用生成式模型;
- 单选题永远会把概率分给某个选项 ,哪怕没有一个合适的;文档建议不要用"以上都不是"当兜底;
- 用户输入的文本可能"自己替自己辩护” ,高风险动作仍需人工或二次校验;
- 数字和日期的比较,交给代码,别交给模型 ;
- 同一请求里的问题彼此看不到;
- 暂不支持上下文缓存和 Batch API,重复输入会被重复计费;Google Cloud(Vertex AI)版本"即将推出”。
另外,大于 16K token 的输入、超过 100 个问题时的延迟表现,官方目前没有公布。
七、写在最后:AI 正在从"会说"走向"会判断”
过去两年,我们习惯了用最强的生成模型去做所有事情,包括那些只需要回答 A、B、C 的事情。
Gemini Decision 1 代表的是另一种思路:把 Agent 里的"判断"从"生成"中拆出来,交给一个更快、更便宜、而且知道自己有几分把握的专用模型。
它不会出现在聊天窗口里,用户几乎感知不到它。但在未来的 Agent 架构里,它很可能会像数据库索引一样——不起眼,却无处不在。
对开发者来说,最值得做的事情也许很简单:翻一翻你的 Agent 日志,数一数有多少次大模型调用,其实只是在做选择题。
参考资料:Google 官方博客《Gemini Decisions API: Fast, calibrated multimodal decisions》(2026.11.11);Google AI Studio Decisions API 文档;CellCog《Gemini Decision 1: Price, Benchmarks and Limits》。文中基准数据来自 Google 官方测试及第三方转录,尚未经独立复现。
相关文章
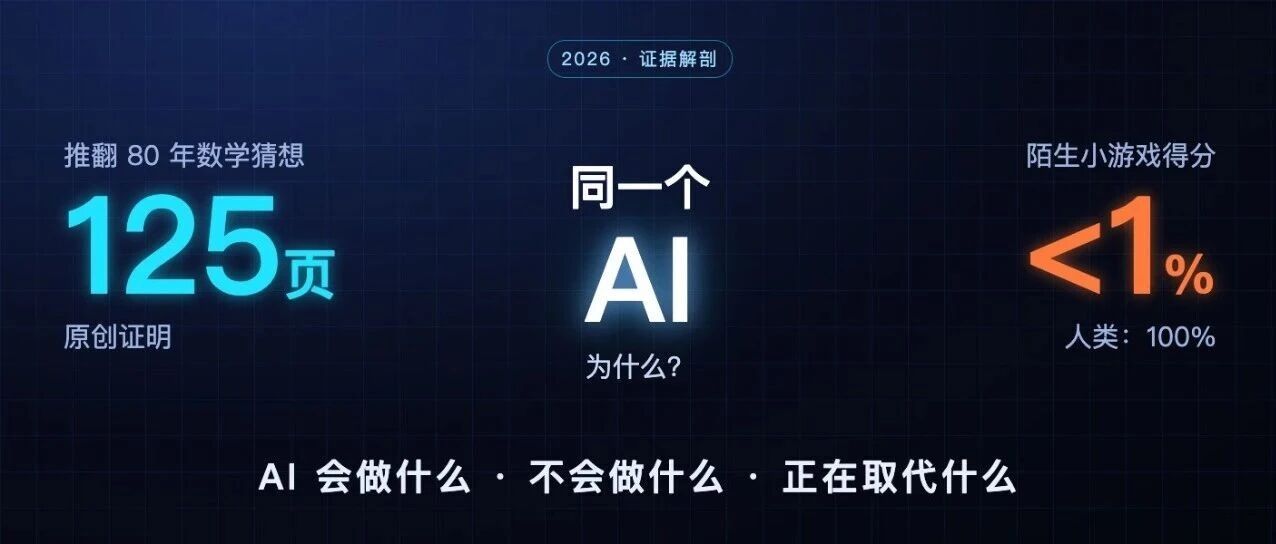
AI会做什么、不会做什么、正在取代什么:一份基于2026年证据的冷静解剖
2026 年,同一代 AI 一边推翻了一个悬而未决 80 年的数学猜想,一边在一组"五岁小孩几秒就能上手"的小
AI 当上「共同研究员」:华为医疗 AI 的真进展与真难题
斯坦福用多智能体「虚拟实验室」设计出有效纳米抗体,华为正把类似思路搬进实验室与医院:科研智能体、盘古药物模型、病理大模型、HAIP 医院 AI 平台。本文梳理进展,也追问证据、湿实验瓶颈与责任边界。
当 AI 走进实验室:从读文献到过审稿,科研流程正在被重写
2026 年,AI 已走完从读文献、提假设、做实验到写论文、审论文的整条科研链路。本文拆解五个环节的真实进展、可信度与边界,并给研究者四条实用建议。